Чи вміє ШІ вигадувати нове: 35 моделей проти 75 людей
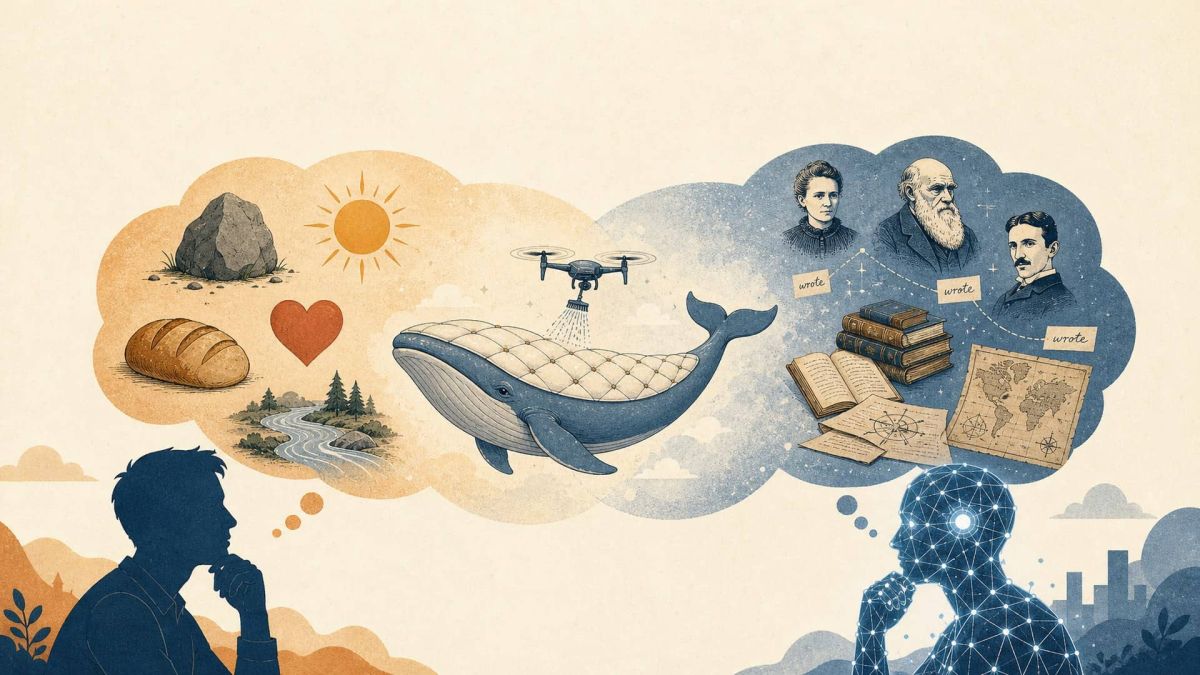
Що спільного у синього кита й матраца? А в Адама Сміта й бактерій? Більшість людей скажуть: нічого. Великі мовні моделі — програми на кшталт ChatGPT чи Claude — відповідають інакше. Вони знаходять зв’язок, будують аналогію і навіть вигадують на її основі новий пристрій. Міжнародна команда науковців перевірила 35 таких моделей і 75 людей на однакових завданнях і з’ясувала, хто кращий у комбінаторній творчості. Результати опубліковано в препринті на arXiv.
Найважливіше про Київ — у Telegram
Тривоги, тарифи, транспорт — коротко і без спаму
Що таке комбінаторна творчість
Альберт Ейнштейн (Albert Einstein) казав, що головна риса продуктивного мислення — «комбінаторна гра». Цю думку зафіксував математик Жак Адамар (Jacques Hadamard) у книзі 1954 року. Пізніше дослідниця Маргарет Боден (Margaret Boden) першою дала явищу формальне визначення. Комбінаторна творчість (combinatorial creativity) — це вміння поєднувати знайомі ідеї незнайомим способом.
Звучить просто. Але саме так з’являлася величезна кількість винаходів і відкриттів. Хтось порівняв атом із Сонячною системою — і запропонував модель з ядром і електронами на орбітах. Сучасні дослідження історії науки підтверджують: найвпливовіші наукові праці зазвичай поєднують ідеї з далеких одна від одної галузей.
Психологи виділяють три форми такої творчості.
- Асоціація — знайти ланцюжок зв’язків між далекими речами. Класичний приклад: Ейнштейн → скрипка → Моцарт. Ейнштейн грав на скрипці, а Моцарт писав для неї музику.
- Аналогія — помітити, що дві різні системи влаштовані схоже. Імунна система захищає тіло так само, як армія захищає країну.
- Змішування понять (conceptual blending) — злити дві ідеї в одну нову, яка має власні властивості. Організм плюс машина дорівнює кіборг.
Третя форма — найскладніша. Кіборг — це не просто «робот, який може хворіти». У нього з’являється те, чого немає ні в живого організму, ні в машини окремо. Наприклад, його частини можна замінити хірургічно, і при цьому не треба чекати, поки заживуть тканини.
Як влаштований іспит для ШІ
Дослідники створили бенчмарк під назвою KOMBINE. Бенчмарк (benchmark) — це стандартний набір завдань, за яким порівнюють різні системи. Щось на кшталт єдиного іспиту для штучного інтелекту.
Головна родзинка KOMBINE — пари понять для завдань обирали випадково. Науковці взяли 283 відомих поняття з 21 галузі: від гравітації й числа пі до джазу, піци й чорних дір. Кожне з них має статті щонайменше у 78 мовних розділах Вікіпедії та споріднених проєктах — тобто їх знають у всьому світі. Потім пари складали з різних галузей. Так виникали завдання на кшталт «Синій кит і матрац», «Фотосинтез і хліб», «Демократія і банківська справа», «Паровий двигун і буддизм».
Навіщо така випадковість? Попередні тести перевіряли, чи впізнає модель уже відомі зв’язки. А справжнє відкриття — це коли зв’язок ще ніхто не описав. Автори хотіли наблизити іспит до умов реальної науки.
Кожне завдання оцінювали за трьома критеріями, які психологи вважають ознаками творчого продукту:
- Користь (utility) — чи виконано умови. Для асоціації кожна ланка має бути фактично правдивою. Для аналогії — обидва ланцюжки мають однакову структуру. Для змішування — спільна схема справді підходить обом поняттям.
- Несподіваність (surprise) — наскільки далекими є поняття у ланцюжку. Вимірюється через «семантичну відстань»: комп’ютер подає слова як точки в багатовимірному просторі смислів, і чим далі точки одна від одної, тим несподіваніший зв’язок.
- Оригінальність (originality) — наскільки відповідь не схожа на те, що дали інші учасники для того самого завдання.
Для аналогій і змішувань було й четверте завдання. Модель мала не просто знайти зв’язок, а вигадати на його основі нове поняття. Тут оцінювали, чи воно оригінальне, чи логічне і чи справді побудоване на знайденій аналогії.
Хто перевіряв відповіді? Теж ШІ. Правдивість фактів оцінювала модель Claude Haiku 4.5. Складніші речі — логічність винаходу, якість змішування — оцінювала колегія з трьох моделей: Claude Haiku 4.5, GPT-o3 і GPT-5.4. Щоб переконатися, що судді не помиляються, один з авторів сам перевірив 60 відповідей наосліп, не знаючи, яка модель їх дала і що вирішили судді. З колегією він погодився у 66% випадків. А коли всі три судді були одностайні — у 75%.
Що вийшло у нейромереж
У дослідженні брали участь 35 моделей: від найновіших флагманів — GPT-6 Astra, Claude Fable 5.1 — до невеликих відкритих систем. Усі працювали з однаковими налаштуваннями випадковості, щоб порівняння було чесним.
Ось як моделі впоралися в середньому:
- правдивий ланцюжок асоціацій — у 59% випадків;
- коректна аналогія — у 53,4%;
- коректне змішування — лише у 43,4%.
Тобто з асоціаціями й аналогіями моделі справляються на 10–16 відсоткових пунктів краще, ніж зі змішуванням. Але головне — дослідникам вдалося точно визначити, де саме моделі провалюються.
Виявилося, що моделі «спотикаються» на найпершому кроці — коли треба назвати спільну схему двох понять. Науковці називають цю схему generic space, «спільний простір». Для організму й машини це, наприклад, «система, частини якої можуть ламатися і замінюватися». Якщо модель цей крок проходила, далі вона описувала логічний злитий концепт у 97,1% випадків. Проблема — саме в абстрагуванні. Автори назвали це «вузьким місцем абстракції» (abstraction bottleneck).
Приклад — пара «Фотосинтез і хліб». З усіх топових моделей лише Claude Opus 4.6 знайшла робочу спільну схему: «активний агент змушує інертну речовину піднятися і стати структурованим багатим на енергію продуктом». Інші провалилися. GPT-5.6 Sol запропонувала схему, де газові порожнини «керують» перетворенням енергії — але в хлібі бульбашки є результатом бродіння, а не його керівником. Claude Fable 5.1 описала «пористу вуглеводну матрицю з повітряними кишенями від живого газообміну» — це підходить хлібу, але не рослині.
Утім, жодне завдання не виявилося нерозв’язним. Для кожної пари понять хоча б одна модель знайшла правильну схему. Чому моделям так важко абстрагувати? Автори лише припускають: можливо, їм бракує життєвого досвіду. Дослідження мозку показують, що людина, коли комбінує поняття, уявляє картинки і «програє» ситуації в уяві. У тексту такої опори немає.
Хто став переможцем
Загальний лідер — GPT-5.6 Sol з 55,2 балами зі 100 можливих. Друге місце — GPT-6 Astra (54,4), третє — Claude Opus 4.6 (52,0). Але цікаво, що в кожному окремому завданні лідери різні. Claude Opus 4.6 найкраще будує асоціації та аналогії. А GPT-5.6 Sol — чемпіон змішування: 64,8 бала проти 41,4 у Claude Opus 4.6. При цьому в аналогіях GPT-5.6 Sol опинилася лише на шостому місці.
Тобто творчість у моделей не однорідна. Модель може блискуче знаходити зв’язки — і погано зливати поняття в нове.
Ще одна закономірність: моделі, які знаходять оригінальні асоціації, зазвичай кращі і в усьому іншому. Оригінальність асоціацій виявилася найкращим передбачувачем успіху в аналогіях і змішуванні. Це підтверджує теорію психолога Сарноффа Медніка (Sarnoff Mednick) ще від 1962 року: вміння поєднувати далекі речі — основа більшості видів творчості.
Один винахід на п’ятьох: чому моделі вигадують однакове
А тепер — найнесподіваніша частина. Моделі вигадали 2070 нових концептів через аналогії та змішування. Кожен описано набором властивостей, усього таких властивостей 7868. Дослідники порівняли їх між собою і виявили «винахідницьку одноманітність» (inventive homogeneity).
Кожен п’ятий концепт (19,9%, або 412 з 2070) мав щонайменше дві властивості, майже дослівно повторювані у винаході іншої моделі для того самого завдання. Науковці називають такі пари «винахідницькими збігами» (inventive multiples) — за аналогією з історією науки, де різні вчені незалежно робили одне відкриття.
Ось приклад. Для пари «Опера і документальне кіно» Claude Fable 5.1 вигадала «оперу свідчень» (testimony opera), а Gemini 3.7 Flash — «доку-оперу» (docu-opera). Обидві монтують архівні кадри. Обидві виводять мелодію з інтонацій записаної мови. В обох свідчення співають. Різні компанії, різні моделі — а ідея одна.
Два чинники посилювали однаковість:
- Тип завдання. На змішуванні концепт мав подвійний збіг з чужим у 37,3% випадків, на аналогіях — лише у 2,6%. Різниця — у 14 разів.
- Спільний розробник. Моделі однієї компанії збігалися у 9,3% випадків, різних компаній — у 4,1%. Тобто у 2,3 раза частіше. Найбільше «родинної схожості» виявили моделі DeepSeek і Anthropic. А от моделі OpenAI, навпаки, збігалися одна з одною навіть трохи рідше, ніж із чужими.
Чому це важливо? Для науки, якій потрібне різноманіття ідей, одноманітність винаходів — серйозне обмеження.
А що люди?
Для порівняння дослідники залучили людей через платформу Prolific — сервіс, де науковці наймають добровольців для онлайн-досліджень. Набрали 120 англомовних дорослих. Після відсіву за ознакою використання ШІ залишилося 75 учасників. Середній вік — 40 років, наймолодшому 20, найстаршому 78.
Кожен виконав по п’ять завдань кожного типу — 15 загалом. Перед початком людям показували приклад, давали простий тренувальний пункт і перевіряли, чи зрозуміли вони правила. Відповіді оцінювали ті самі ШІ-судді за тими самими критеріями. Якщо учасник пропускав завдання, воно отримувало нуль.
Результат виявився неприємним для людської самооцінки. Люди знайшли правдиву асоціацію у 22,1% випадків (моделі — 59%), коректну аналогію — у 32,9% (моделі — 53,4%), коректне змішування — лише у 12,8% (моделі — 43,4%). У загальному заліку люди посіли останнє, 36-те місце з 13,7 бала. Навіть найслабша модель phi-4 набрала 17,4. Щоправда, у двох окремих завданнях люди все ж обійшли по одній моделі: в аналогіях — Kimi K2, у змішуванні — phi-4.
Але є нюанс. Дослідники самі визнають: їхня вибірка — звичайні люди з інтернету, а не вчені, художники чи винахідники. Професійні творці, ймовірно, показали б кращий результат.
І ще одна деталь. Для моделей асоціації — найлегше завдання, а аналогії — трохи важчі. У людей навпаки: аналогії даються легше, ніж асоціації. Спільне в обох — змішування понять найважче для всіх.
Чому змішування важче за аналогію? Автори пропонують пояснення через ідею «стиснення». Аналогія описує одну річ через структуру, яка вже є в іншої. А спільна схема для змішування — це новий опис, який має «стиснути» обидва поняття одночасно. Це важча обчислювальна робота — і для мозку, і для нейромережі.
Різні світи в голові
Найцікавіший висновок стосується не того, хто кращий, а того, хто про що думає. Дослідники нанесли всі відповіді на карту смислів і побачили: люди й моделі живуть у різних її регіонах.
Моделі, виконуючи завдання, згадують відомих людей і місця: Джеймса Клерка Максвелла, Галілея, Лондон. І поєднують їх через інтелектуальні дії: «написав», «названо на честь», «досліджував». Їхній світ — енциклопедичний.
Люди мислять буденними речами, станами й почуттями: камінь, щастя, любов, хвороба, безпека. І поєднують їх через рух і просте буття: «веде до», «рухається», «всередині». Їхній світ — тілесний і емоційний.
Саме тому автори не роблять висновку «ШІ переміг». Навпаки. Якщо дві групи дивляться на одну задачу з різних боків, разом вони бачать більше. Дослідники пропонують системно вивчати співпрацю людини та ШІ у творчих задачах — особливо в науці та винахідництві.
Про що варто пам’ятати
Автори чесно перелічують обмеження роботи. Змішували лише два поняття, хоча в житті їх може бути більше. Завдання були тільки текстовими — а люди творять ще й музику та живопис. Випадкові пари понять наближають іспит до справжніх відкриттів, але гарантувати, що жоден зв’язок ніхто ніколи не описував, неможливо.
Є й ширший контекст. Інші дослідження показують: ідеї, згенеровані ШІ, часто оригінальніші за людські, але гірше втілюються на практиці. Науковці називають це «розривом між задумом і виконанням». Тож вигадати «дрон для чищення китів» за аналогією з пилососом для матраца — це одне. А зробити його — зовсім інше.
Чому це важливо знати
KOMBINE — перший великий інструмент, який вимірює саме комбінаторну творчість, а не впізнавання відомого. Він показує дві конкретні слабкості сучасних моделей. Перша: вони погано абстрагують, тобто важко бачать спільне між далекими речами. Друга: вони вигадують схоже, особливо якщо зроблені однією компанією. З цього випливає практична порада для кожного, хто генерує ідеї з допомогою ШІ: запитуйте кілька моделей різних розробників — і не чекайте від них нових абстракцій там, де потрібен справді свіжий погляд.
Хто автори
Перший автор дослідження — Семюел Шапіро (Samuel Schapiro) з Лабораторії знань Чиказького університету. Серед співавторів — Джеймс Еванс (James A. Evans) з Чиказького університету та Інституту Санта-Фе, Томас Гріффітс (Thomas L. Griffiths) з Принстонського університету, Роджер Біті (Roger E. Beaty) з Університету штату Пенсильванія, а також науковці Іллінойського університету в Урбана-Шампейн, Університету Стоуні-Брук і Амстердамського університету. Препринт опубліковано на arXiv, остання версія датована 7 жовтня 2026 року.
Раніше ми писали

Медіаменеджер і автор-фрілансер з 1991 року. Займається креативним продакшном та розвитком медіа.
Усі статті автора →