Чому нейрони ШІ зрозуміліші, ніж думали вчені
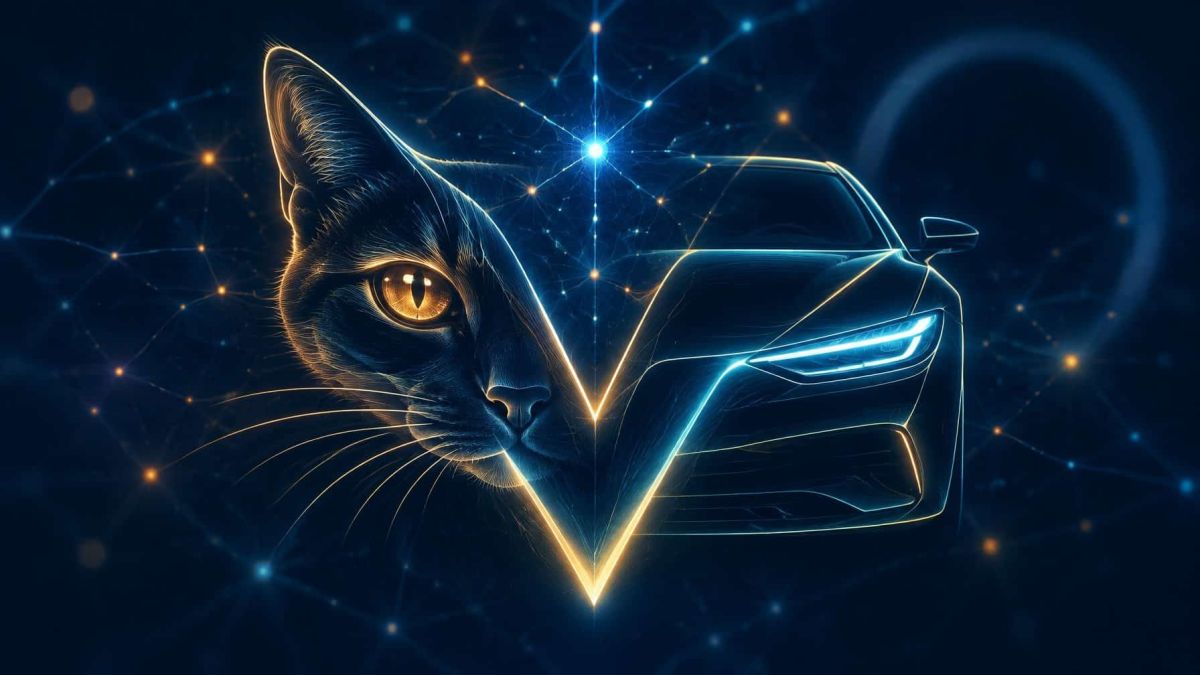
Кілька років один нейрон вважали найвідомішим прикладом того, як заплутано влаштований штучний інтелект. Він реагував і на котячі морди, і на передки автомобілів. Тепер дослідник стверджує: він шукав не котів і не машини, а форму літери V. Таке пояснення дає дослідник Нік Каммарата (Nick Cammarata), який разом із Крісом Олою (Chris Olah) започатковував команду з вивчення нейромереж в OpenAI. Свій висновок він виклав у великому есеї, який опублікувала лабораторія Goodfire, де він працює. У лютому 2026 року інвестори оцінили цю компанію в 1,25 млрд доларів.
Найважливіше про Київ — у Telegram
Тривоги, тарифи, транспорт — коротко і без спаму
Назва есею звучить як виклик: «Нейромережі вже чисті». «Чисті» тут означає впорядковані: майже все всередині має сенс. Автор вважає, що порядку в ШІ набагато більше, ніж здавалося. А отже, зрозуміти, як «думає» машина, може бути цілком реально.
Щоб оцінити, наскільки це сміливо, треба почати з того, як влаштований ШІ зсередини.
Що таке нейрон у штучному інтелекті
Нейромережа складається з мільйонів крихітних обчислювальних вузлів — штучних нейронів. Кожен отримує числа від нейронів попереднього шару, складає їх — одні з більшою вагою, інші з меншою — і передає результат далі. Число, яке видає нейрон, називають активацією. Що більше число, то сильніше нейрон «спалахує».
Нейрони розкладені шарами. Перші шари бачать прості речі: лінії, кольори, вигини. Наступні складають із них частини предметів: колеса, вуха, вікна. Останні шари вже впізнають цілі об’єкти: таксі, сунички, монастир.
Ніхто не прописує нейронам їхню роботу вручну. Мережа сама налаштовується під час навчання, переглядаючи мільйони прикладів. Тому люди отримують робочу систему, але не інструкцію до неї.
Розбиратися, що саме робить кожен вузол, — завдання цілої галузі. Вона називається механістичною інтерпретованістю (mechanistic interpretability). Простіше кажучи, це наука про те, як розібрати ШІ на гвинтики й зрозуміти, навіщо кожен із них.
Ідеальна картина виглядала б так: один нейрон — одна зрозуміла роль. Ось нейрон «колесо», ось нейрон «собаче вухо». Такі нейрони називають моносемантичними — «з одним значенням».
Нейрон, що любив котів і автомобілі
Проблема в тому, що багато нейронів виглядали інакше. Вони реагували на кілька, здавалося б, зовсім не пов’язаних речей. Їх назвали полісемантичними — «багатозначними».
Найславетніший приклад — нейрон із позначкою 4e:55 у мережі InceptionV1. Цю модель розпізнавання зображень Google створила 2014 року. Для дослідників вона стала тим, чим для біологів є дрозофіла: «модельним організмом», на якому галузь робила перші кроки.
Нейрон 4e:55 сильно реагував на морди котів і на передні частини автомобілів. Його згадували в кількох найпопулярніших статтях галузі — з 2017 по 2020 рік. Там він слугував аргументом, що нейрони, можливо, не найкраща одиниця для вивчення ШІ. Нік Каммарата був співавтором однієї з таких статей. У ній прямо писали, що нейрон не реагує на якусь спільну рису машин і котячих морд.
Ще гірше виглядав останній шар InceptionV1. Майже жоден його нейрон не піддавався поясненню. Одна дослідниця писала, що зрозумілих нейронів там практично немає. Сам Нік Каммарата назвав би, можливо, близько 5%.
Теорія «вузла»: суперпозиція
Як пояснити цей хаос? Найпопулярнішою відповіддю стала суперпозиція (superposition). Цікаво, що Нік Каммарата сам був серед авторів цієї ідеї. Тож тепер він, по суті, переглядає власну теорію.
Ідея така. Поки нейронів вистачає, мережа групує схоже зі схожим. Але коли місця бракує, вона нібито змінює стратегію. Тоді вона запихає в один нейрон зовсім різні речі — саме тому, що вони рідко трапляються разом і не заважають одна одній.
Уявіть шухляду, куди складають шкарпетки разом із виделками: вони ніколи не потрібні одночасно, тож і не плутаються. Але, дивлячись на таку шухляду, ви нічого не дізнаєтесь про логіку господаря. Логіки просто немає.
За цією теорією, мережа нагадує туго зав’язаний вузол. Зав’язати його можна було багатьма способами, і всі вони працювали б майже однаково добре. Тож поєднання речей в одному нейроні — майже випадковість. Про логіку мережі воно нічого певного не скаже. Висновок здавався очевидним: спершу вузол треба розплутати, а вже потім вивчати.
На практиці «розплутувати» почали за допомогою другої, допоміжної моделі. Найвідоміша з таких моделей — розріджений автокодувальник (sparse autoencoder, SAE). Це окрема мережа, яка описує роботу оригіналу довшим списком «чистіших» ознак — понять, які нібито розпізнає мережа. «Розріджений» означає, що щоразу вмикається лише кілька ознак. Далі дослідники вивчають уже це наближення, а не оригінал.
Так галузь розділилася на два шляхи:
- вивчати саму мережу — її нейрони, зв’язки і те, як через них тече інформація;
- спершу скласти список гіпотетичних ознак і витягти їх за допомогою дедалі хитріших методів, а саму мережу здебільшого не досліджувати.
Спочатку дослідники йшли першим шляхом, але згодом перейшли на другий. Нейромережі здавалися надто заплутаними, щоб розбиратися в них напряму. Тепер Нік Каммарата вважає, що це враження виникло через низку помилок.
Кілька секунд, які змінили погляд
Після кількох місяців роботи з напрочуд зрозумілими нейронами автор засумнівався. А раптом старі «канонічні» приклади хаосу просто неправильно прочитали?
Він відкрив добре знайому сітку зображень нейрона 4e:55. Бачив її сотні разів. Але цього разу поставив собі інше питання: що тут може бути однією спільною річчю? Відповідь прийшла за кілька секунд. Це нейрон не котів і машин, а форми літери V.
Ймовірно, ідеться про обриси. У котячій морді анфас вуха й підборіддя утворюють загострену форму. Передок автомобіля теж часто сходиться клином. Нейрон реагував на загостреність, а не на «котячість».
Здогадку підтвердили зв’язки. Найсильніше 4e:55 пов’язаний із сусідами, що ловлять речі у формі V:
- язики полум’я;
- струмені води з пожежного катера;
- лисячі морди;
- навіть келих для мартіні.
А на що він відповідає сигналом зі знаком «мінус»? Округле: літера O, м’ячі для гольфу й тенісу, годинник, равлик. Загострене — проти круглого.
Навіщо випадковій суміші «кіт + авто» так сильно цікавитися полум’ям? Ні навіщо. А от детектору форми V — цілком логічно. Здогадку легко перевірити на інших предметах. Нейрон реагує на японські швидкісні потяги сінкансен і на більярдні столи. У них теж можна знайти форму V.
Чому раніше цього не помітили? Інструмент, який малював «портрет» нейрона, додавав котячі вуса. Він сам домальовував зображення, щоб нейрон спалахнув якнайсильніше. Нейрон справді отримує сигнали від «котячих» нейронів. Тож, натрапивши на цей «котячий» шлях, інструмент малював усе, що з ним пов’язане. Так на картинці з’явилися вуса, хоча самому нейрону вони не потрібні. Щоб побачити спільне, треба було намалювати, що об’єднує вхідні сигнали нейрона, а не лише його самого.
Машина серед собак: підвів інструмент
Другим «стовпом» теорії суперпозиції була схема — ланцюжок пов’язаних між собою нейронів. Нік Каммарата сам знайшов її 2019 року. Тоді він показав її Крісові Олі. Здавалося, що нейрон «автомобіль» передає свій сигнал у групу нейронів, які відповідають за собак.
Дослідники пояснили це так: мережа ховає «машину» серед собак, як у таємній схованці, а потім дістає назад. Цю схему навели в статті 2020 року як єдиний приклад суперпозиції. Наскільки відомо автору, другої такої схеми відтоді ніхто не опублікував.
Насправді, за висновком автора, машини й собак поєднувала поза. Тобто те, як предмет повернутий до камери: боком, анфас, під кутом. В InceptionV1 знайшлося понад сотню таких нейронів «узагальненої пози». Кожен чітко ловить один ракурс, спільний для машин, собак та інших предметів. Доти їх, схоже, ніхто не помічав.
Ніякої схованки не було. Жоден нейрон далі в мережі не «дістає» машину з цієї суміші напряму. Навпаки, сигнал розгалужується: на нейрони окремих типів машин і на дедалі точніші ракурси.
Друга причина помилки — інструмент. Метод візуалізації ознак (feature visualization) малює картинку, яка найсильніше збуджує нейрон. Робить він це покроково: щоразу трохи змінює зображення так, щоб нейрон спалахував сильніше. І обирає найлегший шлях.
У навчальних даних InceptionV1 дуже багато собак, а в мережі — багато «собачих» нейронів. Тож метод на самому початку звертав на «собачу» стежку й уже не міг з неї зійти. Науковці називають таке явище «обманом винагороди» (reward hacking): метод досягає мети не тим шляхом, якого від нього чекали.
Варто було злегка підштовхнути візуалізацію до шляхів, якими йдуть справжні фото, — і картина змінилася. Із чотирьох «собачих» нейронів два виявилися нейронами машин. Ще два — нейронами пози, спільної для машин і собак.
Може, мережа просто «хотіла» мати окремі нейрони для пози собак і пози машин, але їй бракувало місця? Автор перевірив модель DINOv2. Вона більш ніж удесятеро більша й новіша приблизно на десять років. Нейронів пози в ній більше, але багато з них усе одно спільні для собак і транспорту. Таке він бачив у кожній моделі розпізнавання зображень, яку досліджував, незалежно від її розміру.
Нейрон — це не іменник, а дієслово
Звідки така системна помилка? І люди, і автоматичні системи схильні описувати нейрон як детектор групи іменників: «коти й машини». Іноді нейрон справді реагує на групу предметів. Але, з досвіду автора, частіше він ловить спільну рису, як-от форму V. Тому нейрон краще уявляти як дієслово, а не іменник: важливо не що він називає, а що він робить.
Нік Каммарата пропонує простий прийом. Спробуйте описати нейрон, не використовуючи жодних назв предметів. Зазвичай спільна риса проявляється одразу. Автор підозрює, що це головна причина помилкової «багатозначності» в середніх шарах: одну рису описують списком предметів.
Сам він тепер уявляє нейрон радше як залізничну стрілку. Нейрон не стільки називає побачене, скільки скеровує потік сигналів. У нейрона два полюси, як у батарейки: «плюс» і «мінус». На те, що він шукає, нейрон відповідає сигналом зі знаком «плюс», а на протилежне — зі знаком «мінус». Так він розрізняє дві різні форми, наприклад V і O, і відправляє сигнал у різні ділянки мережі.
Ось як це працює. На ранніх етапах машини й собаки можуть іти разом, бо мають спільну позу. Далі стоять вузькі детектори — для таксі, для швидкої допомоги. Їм собаки не потрібні. Тому перед ними є нейрон-«ворота». На машини він відповідає «плюсом», на собак — «мінусом» і так відсіює їх. Собаки йдуть у власну «собачу» ділянку.
Автор простежив шлях справжнього фото спортивного авто через останні п’ять із 18 блоків (груп шарів) найбільшої з трьох версій ConvNeXt, які навчив автор, — про них мова піде нижче:
- спершу авто й лімузини відділяються від автобусів і трамваїв;
- потім машина опиняється в групі прямокутних форм — разом зі столами й шафами, на противагу зміям і собакам;
- далі кабріолети й спорткари відокремлюються від мікроавтобусів;
- далі кабріолети протиставлені фургонам і універсалам, а в останньому блоці — тільки універсалам.
Щоб зрозуміти нейрон, наголошує автор, його «мінус» важить майже стільки ж, скільки «плюс». Навіть у мережах, де сигнали зі знаком «мінус» обрізають до нуля, цей полюс однаково формується під час навчання. В останньому шарі найбільшої моделі нейрони розрізняють дуже схожі речі: на одне реагують «так», на інше — «ні». Таксі й швидка, броколі й цвітна капуста, птахи косарі й фламінго, вовки й хаскі, рукавиці й шкарпетки.
«Мінус» ще й допомагає швидко перевірити здогадку. Згадайте нейрон V: на його «мінусі» — округла O.
Історія помилок мікроскопа
За словами Ніка Каммарати, історія галузі — здебільшого низка відкриттів одного типу. Щоразу з’ясовувалося, що сама мережа влаштована краще, ніж здавалося. Просто «мікроскоп», тобто інструменти для зазирання всередину, був погано налаштований.
Метод візуалізації дав відомі психоделічні картинки. Але спершу вони виходили невиразними. Згодом з’ясували, що методу бракувало стійкості до дрібних зсувів і поворотів зображення. Коли її додали, «портрети» тих самих нейронів раптом стали чіткими.
Ближче до кінця мережі метод знову ламався. Причини — той самий «обман винагороди» і не зовсім вдалі налаштування. Кілька тонких поправок — і стало видно значно глибше. Ті самі нейрони, кращий мікроскоп.
Але проблема була не лише в «мікроскопі». Саму модель теж треба було покращити. Автор порівняв InceptionV1 із сучаснішою мережею ConvNeXt такого самого розміру, навченою на тих самих даних. Остання має кілька інженерних покращень, придуманих зовсім не для зрозумілості, а щоб мережі краще вчилися.
Одне з них — залишкові зв’язки (residual connections). Це «обхідні доріжки», якими інформація може проходити повз шар. Ще одне — нормалізація шарів (LayerNorm), яка тримає числа в розумних межах.
Ось як змінювалася частка зрозумілих нейронів в останньому шарі:
- InceptionV1 з інструментами минулих років — близько 5% (за оцінкою автора), за іншими оцінками майже нуль;
- та сама мережа, але з кращими інструментами — близько 50%;
- та сама архітектура, перенавчена з розумнішими сучасними налаштуваннями, — близько 70%;
- ConvNeXt того самого розміру — близько 99%.
Отже, останній шар InceptionV1 погано навчався через вади архітектури, тобто будови мережі, і тому виглядав хаотичним. Слабкі інструменти лише підсилювали враження хаосу. Розмір моделі й дані при цьому не змінювалися.
Нік Каммарата навчив три версії ConvNeXt. Їхній розмір міряють у параметрах — числах-«регуляторах», які мережа налаштовує під час навчання. Найменша має 92 тисячі параметрів, найбільша — 28,6 мільйона. Тобто вони різняться приблизно в 300 разів. Середня має 7,06 мільйона параметрів, як і InceptionV1. Загалом зрозумілою виявилася кожна. Середню з них автор називає першою справжньою, а не іграшковою нейромережею, яку, як йому здається, він здебільшого розуміє.
А що, як мережа менша? Вона не звалює в одну купу випадкові речі. Просто її нейрони стають «ширшими». Наприклад, один нейрон охоплює багато різних машин. У більшій мережі він розгалужується на окремі нейрони для конкретних видів авто.
У найменшій ConvNeXt є нейрон для наземного транспорту загалом: машин, потягів, возів. На протилежному полюсі в нього човни й літаки. Там опинився і віз, запряжений волами, посеред води. Автор зізнається, що навіть не знав, що таке буває.
Як ростуть гілки: рекурсивне узагальнення
А чим був хаос в останньому шарі старої InceptionV1, поки його ще не «вилікували»? Нік Каммарата перенавчив мережу й простежив, як формується один із нейронів.
Спершу нейрон реагував на поля квітучого жовтого ріпаку. На деяких із цих фото була ще й собака. Далі нейрон почав поширюватися на кожну складову цих фото:
- до інших пейзажів;
- до зелених предметів — тенісних м’ячів, зелених яблук, плодів джекфрута;
- до собак у траві та серед жовтих квітів, а згодом — до кудлатих собак;
- до броколі.
Наприкінці навчання нейрон реагував здебільшого на тенісні м’ячі, тер’єрів і броколі. Поля ріпаку майже зникли. Збоку це виглядає як безглузда суміш. Але крок за кроком кожен перехід логічний. За словами автора, так розростався кожен нейрон, який він перевіряв.
У ConvNeXt, навченій на тих самих даних, відповідний нейрон теж спершу потягнувся до м’ячів і фруктів. Але згодом облишив їх і залишився на полях ріпаку. У покращеній архітектурі розростання теж є, але значно слабше.
Автор назвав це явище рекурсивним узагальненням (recursive generalization). Нейрон росте як гілка дерева: спершу в одному напрямку, потім пускає паростки, а ті — свої паростки. Кожен окремий крок зрозумілий. Але в підсумку нейрон перестає бути «однозначним».
Приклад із мовної моделі. Нейрон спочатку реагував на буквосполучення «iy» — зокрема в прізвищі японського режисера Хаяо Міядзакі (Miyazaki). Потім на «diy» — англійське скорочення від «зроби сам». А згодом і на повну фразу «do it yourself», де «iy» немає взагалі.
Інші приклади:
- нейрон, пов’язаний із геологією Місяця й Марса, реагує ще й на код бібліотеки Cesium, якою малюють тривимірні глобуси;
- нейрон «ворог» спрацьовує на російський вірш про ворогів;
- нейрон, налаштований на прізвище Srinivasan (Шрінівасан), трохи реагує на білкову базу даних UniProt. Можливо, тому що серед людей, пов’язаних із проєктом, є кілька Шрінівасанів. Але напевно сказати важко.
Цікаво, що сама ідея не нова. Уперше на неї натякнули ще 2021 року у статті «Мультимодальні нейрони» (Multimodal Neurons), співавтором якої був Нік Каммарата. Там явище назвали «зрощеними ознаками». Але ця згадка загубилася в маловідомому підрозділі, і автор сам про це забув. Згадав лише через кілька місяців роботи над рекурсивним узагальненням, коли переглядав найвідоміші моделі галузі.
Наскільки пам’ятає автор, тоді ніхто, зокрема й він сам, не припустив, що це може бути загальне пояснення, наприклад для хаосу в останньому шарі InceptionV1. Побачити, як нейрон росте, не вдавалося: від тієї моделі не лишилося проміжних збережень з різних етапів навчання. Проте, як тепер вважає автор, пояснення загалом було правильним.
Узагальнення проти суперпозиції
Отже, маємо два пояснення «багатозначних» нейронів. І вони майже протилежні.
Узагальнення об’єднує схоже. В одному нейроні збирається спільна риса, на якій зручно будувати далі. Суперпозиція об’єднує непов’язане — саме тому, що такі речі не заважають одна одній.
Автор пояснює різницю на прикладі. Узагальнення створило б нейрон «вислі собачі вуха» — тобто безліч трохи різних вислих вух, різної форми й під різними кутами. Суперпозиція створила б нейрон «вислі собачі вуха + латинська поезія».
Тому ці теорії дають протилежні передбачення. Узагальнення має бути локальним: нейрон тягнеться до сусідніх за змістом речей. Суперпозиція має бути нелокальною: вона «хоче» поєднувати якомога далекі речі. А це можна перевірити, просто спостерігаючи, як росте нейрон.
Різниця принципова. Якщо мережа згрупувала речі через узагальнення, із самого групування можна чогось навчитися. Дві випадкові речі в суперпозиції нічого такого не скажуть. До того ж узагальнення, за словами автора, фрактальне. Тобто воно повторює себе в дедалі дрібніших деталях, як гілка, що ділиться на гілочки. Тож і пояснення можуть бути такими: спершу загальний опис, а потім, за потреби, збільшувати масштаб, як на мапі.
Плутанини додають і терміни. Слово «суперпозиція» вживають у кількох значеннях. Інколи воно означає лише те, що ознак у мережі більше, ніж «вимірів» — грубо кажучи, нейронів, якими вона їх записує. Але таке буває навіть в ідеально зрозумілій мережі: нейрони поєднуються між собою, як літери в слова. Нік Каммарата вважає, що в цьому значенні суперпозиція загалом не є поганою новиною. Він дотепно зауважує, що саме слово «суперпозиція» перебуває в суперпозиції між кількома значеннями.
Тож автор зосереджується на іншому значенні: суперпозиція як особливий принцип навчання. За цією ідеєю, мережа пакує в один нейрон непов’язані речі, бо вони рідко трапляються разом і тому майже не заважають одна одній. Саме від цього найбільше залежить, добрі чи погані новини чекають на галузь.
Суперпозиція, що весь час відступала
Автор визнає: роками він був переконаним прихильником суперпозиції. А нейрони мовних моделей почав вивчати взагалі з іншої причини. Він хотів перевірити, чи мають ШІ-агенти — програми, які самостійно виконують завдання, — «дослідницький смак» — чи ставлять вони слушні питання, перевіряючи пояснення.
Нейрони мали стати лише відправною точкою. Нік Каммарата чекав, що агенти натраплять на безнадійно заплутані уламки суперпозиції. Тоді він отримав би чесну мірку того, наскільки «чисті» нейрони насправді. Після цього агенти перейшли б на зручніші, «розплутані» ознаки. Але цей момент так і не настав. Нейрон за нейроном отримував просте пояснення. Ба більше, ці пояснення передбачали несподівані речі, і передбачення справджувалися.
Ось кілька історій.
У потужній мовній моделі знайшовся нейрон, що реагував на буквосполучення «pr». А ще — на якісь закодовані інтернет-адреси та на бенгальський текст. Здавалося, ось вона, справжня безладна суміш. Але адреси були закодовані у форматі Base64. Він перетворює текст на нечитабельну суміш латинських літер, цифр і знаків. Після розкодування в них виявилися слова на «pr». А бенгальські слова в латинському записі починалися з того ж звукосполучення: «prodhan» — головний, «prothom» — перший, «proshnoti» — запитання.
У моделі Qwen колега автора натрапив на нейрон, який стандартна автоматична перевірка позначила як «багатозначний нейрон ком». Але, придивившись, дослідники побачили інше: нейрон стежив за всім, що стосується штату Колорадо. Це місцеві телефонні номери, сленг і зв’язки з іншими «колорадськими» нейронами. А коми виявилися місцями, де модель тримала підсумок усього «колорадського», що вже прозвучало в тексті.
Схоже, модель узагалі любить складати такі підсумки саме на розділових знаках. Дослідники назвали це «мотивом підсумку» (summary motif) — типовим прийомом, який модель використовує знову й знову. У прикладі з есею перші коми в тексті лишаються «темними». Але щойно згадується Денвер, столиця штату, кожна наступна кома спалахує, і сигнал наростає.
Здогадку про «колорадський» нейрон перевірили прийомом «керування» (steering). Під час роботи моделі сигнал нейрона штучно підсилили, ніби весь текст про Колорадо. І модель почала планувати похід у гори.
Ще один випадок: спершу дослідники давали агентам лише два абзаци тексту. Через це всі нейрони, яким потрібен довший контекст, виглядали хаотичними. Наприклад, один нейрон здавався детектором «кави й університетів». А справжня причина була вище в тексті — за межами тих двох абзаців.
А інший нейрон узагалі не спрацьовував сильно ні на що. Згодом з’ясувалося, що він шукає характерні прикмети медичних сайтів-пустушок, які створюють лише для того, щоб піднятися в пошуку. Просто таких текстів бракувало в наборі даних.
Попри сотні таких випадків, автор довго тримався своєї віри. Він просто щоразу переносив суперпозицію в нове місце. Якщо сильні сигнали нейрона пояснювалися, вона мала ховатися в слабких. Або в комбінаціях нейронів. Або в нейронах, які він ще не переглянув. Або десь між шарами.
Зрештою він замислився: якщо він, сам того не помічаючи, не відбирав лише «зручні» нейрони, то нові спостереження не збігаються з висновками про старі моделі. Він повернувся до первинних доказів — і вони не витримали перевірки.
Тепер Нік Каммарата визнає, що вважав суперпозицію поясненням за замовчуванням. А мав би розглядати її в останню чергу: це найрадикальніша ідея, і її найважче перевірити. Єдиний «симптом» суперпозиції — те, що нейрон не має сенсу. Але так само виглядають і цілком буденні проблеми:
- погані інструменти (як візуалізація, що замість машин малювала собак);
- невдала архітектура мережі (як в останньому шарі InceptionV1);
- рекурсивне узагальнення, яке ще не простежили (як нейрон «iy»);
- узагальнення, яке ще не розгадали (як кіт і машина).
Лікарі мають схоже правило: почувши тупіт копит, думай про коней, а не про зебр. Спершу перевіряють звичайні причини, а вже потім рідкісну екзотику.
Автор нагадує про статтю Anthropic 2022 року. Там прямо визнали: суперпозицію в спільноті часто беруть за пояснення за замовчуванням. Просто тому, що вона здається переконливішою за інші. Хоча доказів мало. Наскільки відомо Ніку Каммараті, після його власної схеми, яка виявилася помилкою, жодної схеми суперпозиції в реальній мережі ніхто не знайшов.
Чи не впадає він у протилежну крайність — вигадувати кожному нейрону гарну історію? Автор відповідає двома аргументами. По-перше, всі інші причини можна перевірити. Кращий інструмент або пояснює нейрон, або ні. Перенавчання з кращою архітектурою показує, чи справа в навчанні. Ріст гілок можна спостерігати крок за кроком.
По-друге, справжні пояснення вузькі. Якщо нейрон — «колорадський», його можна підсилити й подивитися, що напише модель. А «щось, що не має сенсу» підходить під будь-що.
І, зрештою, не обов’язково вигадувати пояснення. Якщо не впевнений — можна так і сказати.
Що буває з нейронами, коли їм тісно
Чому автор так ретельно вивчав саме малі мережі для розпізнавання зображень? Бо в них усе видно найкраще. А мовні моделі величезні, для них немає таких зручних інструментів, як візуалізація ознак, а їхні закономірності часто несподівані.
Автор пояснює різницю влучним порівнянням. Якщо ви дивитеся на розмите фото й вирішуєте, кіт там чи пес, розмиття заважає, але не схиляє до жодної відповіді. А якщо вирішуєте, чи розмите саме фото, чи це у вас поганий зір, — кожна вада вашого зору зарахується як розмитість фото. З багатозначністю нейронів так само: кожна вада інструментів може зробити «однозначний» нейрон схожим на хаос.
Тож Нік Каммарата влаштував нейронам стрес-тест. Він узяв шар 3b мережі InceptionV1. Там живуть детектори вигинів — на думку автора, одні з найважливіших базових нейронів. У цій мережі немає обхідних доріжок, тож сигналу нікуди подітися. Автор зменшив кількість нейронів у шарі з 480 до 10 і навчив мережу заново.
Стиснення у 48 разів. Якби мережа перейшла на суперпозицію, мали б з’явитися химерні суміші: вигин плюс помаранчева спіраль плюс павутиння. Але нічого подібного. Нейрони лишилися зрозумілими, лише стали ширшими:
- один нейрон «вигини й петлі» замість десяти окремих детекторів вигинів;
- два нейрони кіл замість кількох типів кіл;
- окремі нейрони для червоного, жовтого, похилих і вертикальних країв, очей і облич.
Мережа з таким «вузьким місцем» усе одно правильно впізнавала об’єкт із першої спроби в 58% випадків.
А раптом десять чистих детекторів вигинів сховалися в комбінаціях цих десяти нейронів? Автор навчив на стиснутому шарі розріджений автокодувальник, щоб їх витягти. Чистих вигинів той не знайшов. Тільки широкі, розмиті ознаки, що збиваються в купу.
Той самий експеримент він повторив з останнім шаром середньої ConvNeXt. Скоротив його з 1024 нейронів до 13 і перекрив обхідні доріжки. І знову нейрони стали ширшими, але не безглуздими.
Автор також простежив схеми в останніх шарах — щоб переконатися, що останній шар не якийсь особливий. Як мережа доходить до висновку «монастир»? Через нейрони кам’яних стін, дахів і арок, дзвіниць. А на шляху до «сонечка» (комахи) — через нейрони плям і отворів, червоних цяток і плямистих червоних поверхонь, як-от у мухомора. Мережа впорядкована від початку до кінця.
Що знаходять «словники»
Якщо комбінації нейронів справді щось приховують, розріджений автокодувальник мав би знайти «цеглинки», яких у нейронах немає. Автор навчив кілька таких «словників» і шукав разом з агентами. Не знайшов жодної.
Здебільшого обидва набори виглядали саме тим, чим вони є за будовою. Нейрони — це цеглинки, а одиниці «словника» — ті самі цеглинки, згруповані за контекстом. Найнаочніше це вийшло з павуками. Одиниці «словника» означали павуків у різних обставинах. А нейрони — обриси лап і павутиння.
«Словник» допомагав відповісти на питання «що на цьому фото?» — особливо в найменшій моделі з її «широкими» нейронами, що охоплюють цілі групи понять. Але щось фундаментальне, чого не мали нейрони, він так і не вловив. Якщо модель певного розміру не розуміла бейсболістів, не розумів їх і її «словник». А коли модель нарешті їх «зрозуміла», за це відповідав окремий нейрон.
Цифри теж показові. В останньому шарі 88% роботи «словника» — майже точні копії окремих нейронів. Решта — слабкі сигнали. Якщо прибрати всі одиниці «словника», що не збігаються з жодним нейроном, точність моделі не змінюється. А те, що «словник» додав, — це нестрогі групи з наявних нейронів: «тварини біля поверхні води» чи «бліда грудкувата їжа».
Ще одна перевірка. Інформацію в шарі можна записати по-різному — ніби повернути ту саму карту на столі. Автор шукав такий «поворот», за якого основну роботу виконують лише кілька одиниць. Пошук починали з випадкового положення. І щоразу він приводив назад до звичайних нейронів — у кожному блоці мережі.
Парасолька, що стала бджолою
Багато побоювань щодо прихованих ознак стосуються рідкісних речей. Вони рідко з чимось перетинаються і, здається, не варті окремого нейрона. Тож мережа нібито могла б «запхати» їх у якусь випадкову комбінацію. Автор перевірив це кількома способами.
Виявилося, що рідкісне часто навіть компактніше. Для набору фото ImageNet мережі потрібно безліч «собачих» нейронів, бо порід собак там багато. А для трицератопса вистачає одного.
Найнезвичніші для мережі зображення теж розпізнавалися звичайними нейронами, просто помилково. Колібрі вона сприйняла як морозиво. Гігантський банан — як склепіння, тобто арочну стелю. Чоловіка в перекинутій тачці — як газонокосарку.
Автор навіть навчив модель відповідати на випадковий шум випадковими мітками. І тут мережа частково спиралася на осмислені речі: на текстуру вовни й далеких дерев. Вони дрібнозернисті, трохи схожі на шум.
А тоді він змусив середню модель завчити нісенітницю: що фото парасольки — це бджола. Уявіть, що мережа заводить таємну окрему ознаку, яка реагує лише на пікселі цього фото й відрізана від усього іншого. Це були б погані новини. Але сталося інакше.
За дев’ять кроків навчання головна відповідь змінилася так: парасолька — травневе дерево (святковий стовп зі стрічками) — бджола. «Парасолькові» нейрони пригасли, а наявні «бджолині» засвітилися. Майже все відбулося в останніх трьох блоках. Якщо пересадити лише їх у початкову модель, вона теж казатиме «бджола».
Імовірність відповіді «парасолька» впала з 44% до 0,03%, а «бджола» зросла з 0,07% до 53%. Автор порівнює це зі з’їздом між двома дорогами, які вже існують. Будувати окрему дорогу з нуля теж можливо, але, на думку автора, це повільніше й ненадійніше. Окремої «дороги з нуля» він не бачив у жодному експерименті.
Ще одне спостереження з усіх експериментів: завчене напам’ять зазвичай розташовується якомога ближче до виходу мережі. Адже йому треба лише «підглянути» відповідь.
У мовних моделях картина схожа. Модель продовжує рядок вірша Едгара По «Once upon a midnight» словом «dreary» («похмурої»). Нейрони, пов’язані з По та з опівніччю, посилюють сигнал «знайомий літературний текст». Якщо прибрати нейрон По, ймовірність правильного слова падає з 87% до 50%. Але якщо прибрати лише його прямий внесок у відповідь, вона майже не змінюється — 85%. Отже, значна частина його роботи — підказувати решті мережі, що робити далі.
В одному з експериментів дослідники «відрізали» лише найсильніші спалахи нейронів по всій мережі. І модель перестала цитувати біблійний 23-й псалом. Ба більше — почала запевняти, що такого псалма не існує. Випадкові втручання такого самого обсягу псалом не зачепили. А от прицільне погіршило й інші навички моделі, зокрема написання коду, хоча частина арифметики ще працювала.
Чи важливі слабкі сигнали
Часто звучить таке заперечення: а як щодо слабких спалахів? Можливо, суперпозиція ховається там.
Автор вважає, що це малоймовірно. Слабкі сигнали з’являються незрівнянно частіше, ніж сильні. Через один нейрон моделі Qwen3-32B пропустили 100 мільйонів шматочків тексту. Майже всі сигнали — біля нуля. Лише близько 160 досягли хоча б половини максимуму. Захована «чужа» ознака стикалася б зі слабкими сигналами в багато разів частіше. А виграла б від цього дуже мало.
А може, ознака розмазана по слабких сигналах багатьох нейронів одразу? Перевірка проста: прибрати майже всі слабкі сигнали в мережі. Ось результат для середньої моделі ConvNeXt:
- прибрали найслабші 75% сигналів — точність знизилася з 72% до 71%, змінилася приблизно кожна десята відповідь;
- прибрали найсильніші 7% з такою самою загальною «вагою» — точність обвалилася до 4%, змінилося 96 відповідей зі 100.
І які саме відповіді змінилися в першому випадку? Ті, де мережа й так вагалася між двома близькими варіантами. Ескімоська собака стала сибірським хаскі. Коник — цвіркуном. Тигровий кіт — котом табі (у наборі зображень ImageNet це два окремі, дуже схожі класи). Тобто слабкі сигнали зазвичай відповідають за тонкі розрізнення, а не за приховані ознаки.
Найбільше від втрати слабких сигналів страждають місця, які якраз дуже легко зрозуміти. У мовних моделях — останній шар. Він часто «гасить» окремі слова, щоб модель могла про щось «подумати», не кажучи цього вголос. У моделях зображень — ранні шари. Вони працюють як повзунки яскравості: там різниця між «трохи яскраво» і «помірно яскраво» важлива. А пізнішому детектору, скажімо, королівського пінгвіна, байдуже, чи доказів «мало», чи «зовсім мало».
А як щодо сильних, але не найсильніших спалахів? Автор каже, що в усіх відомих йому випадках вони розходяться за змістом колами. Наприклад, нейрон «Трамп» у моделі CLIP найсильніше реагує на фото Дональда Трампа. Слабше — на мистецтво та людей, пов’язаних із ним. Ще слабше — на студії Fox News. Слабкі спалахи нейрона «Титанік» підтягують історії про морські мандрівки загалом і парові машини тієї епохи.
Автор радить мислити не процентилями, а сторінками тексту. Процентиль показує, яка частка випадків слабша за цей: 99-й означає, що 99 зі 100 спалахів слабші. 99-й процентиль звучить як «дуже рідко». Але це один шматочок тексту зі ста — приблизно чотири рази на сторінку. Для нейрона, що ловить якесь тонке почуття, це забагато. 99,9-й процентиль — раз на дві-три сторінки. 99,99-й — раз на 25–30 сторінок.
Нейрони, на думку автора, — передусім майстри аналогій. Якщо в тексті йдеться про морську подорож, модель може оцінити її як «трохи схожу на Титанік». Тому нейрон «Титанік» і спалахує слабко. Автор вважає, що зазвичай мало користі думати про окрему «ознаку морської мандрівки», розмазану по багатьох нейронах.
З сотень слабких сигналів, які Нік Каммарата відстежив вручну, майже всі виявилися пов’язаними з основною роллю нейрона. Деякі зв’язки дотепні. Нейрон дзен-коанів — коротких парадоксальних притч буддійських учителів — слабко спалахує на рекурсії в математиці. Рекурсія — це коли щось визначають через саме себе. Багато коанів побудовані на такому самому «замиканні на себе»: питання повертається до того, хто питає, — до самого спостерігача.
Що всередині мовних моделей
Частину роботи з мовними моделями автор виконав разом із колегою Куртом Тіггесом (Curt Tigges). Детально її опишуть в окремій технічній статті.
Почали з відомого прикладу Anthropic. Компанія досліджувала, як її модель Claude 3.5 Haiku ставить медичний діагноз. Для цього вона використовувала допоміжну модель — транскодер, що перекладає роботу мережі в «чистіші» ознаки. Але навіть найбільший такий транскодер передбачає те саме наступне слово, що й оригінал, лише в половині випадків.
Нік Каммарата з колегою відтворили той самий ланцюжок «міркувань» на звичайних нейронах моделі Qwen3-32B — без будь-яких допоміжних моделей. Ідеться про прееклампсію — небезпечне ускладнення вагітності. «Вузол діагнозу» склали лише чотири нейрони. Якщо їх прибрати, модель починає питати про свербіж. А це характерна ознака іншого захворювання печінки під час вагітності. Наче модель перейшла до наступної версії.
Ще один приклад показує, наскільки важливий «мінус» нейрона. В одній задачі модель мала здогадатися, що йдеться про Санту. Якщо прибрати вісім нейронів, у яких тема Санти живе саме на «мінусі», впевненість моделі падає з майже стовідсоткової до 6%. Вона починає звинувачувати домашнього улюбленця. А якщо прибрати двадцять нейронів, позначених як «Різдво» чи «Санта», впевненість падає лише до 76%. Стандартні автоматичні системи можуть підписати ці нейрони як «столиці країн», бо не зважають на «мінус».
Автори показали і схему «міркувань» моделі Kimi K3, яка має кілька трильйонів параметрів. Наскільки їм відомо, це перший опублікований граф атрибуції (attribution graph) такої великої моделі. Граф атрибуції — це карта того, які нейрони і в якому порядку вплинули на відповідь. Модель спитали, що робити зі знайденим гаманцем. Вона пов’язала гаманець, гроші й посвідчення власника з поняттями «загублені речі» та «чесність». І відповіла: повернути. Повноцінних перевірок моделей такого розміру дослідники ще не починали, але планують найближчим часом. Але поки більшість того, що вони бачили, зрозуміла інтуїтивно.
Можна було б чекати, що мовна модель почне пакувати непов’язане. Скажімо, імена чи пари слів, бо їх безліч. Але ні. Наприклад, нейрон «Міядзакі» отримує сигнали від загальних нейронів, що розпізнають шматочки слів, як-от «iy». Він спрацьовує на прізвище режисера Хаяо Міядзакі в усіх системах письма, які перевірили дослідники. А далі передає сигнал асоціаціям на кшталт назви його мультфільму «Віднесені привидами».
Попередні перевірки моделі Qwen3-32B дали таку картину:
- близько 90% полюсів нейронів («плюсів» і «мінусів» окремо) мають одну головну роль, часто з дрібними спорідненими відгалуженнями;
- ще близько 7% мають дві споріднені ролі;
- лише 2–4% поки не вдалося пояснити.
Схожі результати отримали для моделей до трильйонів параметрів. Для порівняння: 2023 року в одному дослідженні Anthropic типовий нейрон маленької одношарової моделі отримав 0 балів із 14. Тобто дослідник навіть не зміг припустити, що він робить. А в проєкті OpenAI, який Нік Каммарата тоді започаткував, зрозумілими вийшли лише близько 1,7% нейронів.
Автор застерігає: точні відсотки залежать від того, де провести межу «однієї ролі». Наприклад, чи вважати одним цілим схожі ідіоми двома мовами. За його словами, для розуміння мереж це питання не таке вже й важливе. Набагато важливіше, чому різні речі опинилися в одному нейроні.
Нейрона, що робить, скажімо, десять непов’язаних речей, автор не бачив ніколи. А відгалуження не схожі на «сплячих агентів» — рідкісні, але дуже важливі сигнали. Навпаки: вони трапляються рідше і важать менше, ніж основна роль нейрона.
Великим джерелом «шуму» виявилася одна технічна особливість сучасних моделей. Їхні нейрони типу SwiGLU множать два числа: «заслінку» (gate) і «значення» (value). Коли обидва зі знаком «мінус», результат виходить зі знаком «плюс». Як мінус на мінус дає плюс. Тож нейрон видає «плюс» на речі, які за змістом належать до його «мінуса». Звідси й плутанина.
Зазвичай цей «подвійний мінус» дає лише слабке відлуння. Але приблизно в 4% нейронів він займає всю верхівку списку найсильніших спалахів. Якщо вимкнути такі сигнали в усій мережі, більшість тестів моделі навіть покращується, хоча частина тестів на міркування погіршується. Автори закликають розробників архітектур подумати, як це виправити.
У моделях зображень видно, як ці дві частини ділять роботу. «Значення» вчиться чогось широкого: дрібних сірих пташок чи всього помаранчевого. А «заслінка» відчиняється лише для вузького: тільки для юнко (невеликих північноамериканських пташок) чи тільки для золотих рибок.
Чимало сучасних моделей складаються з «експертів» (Mixture of Experts). Це групи нейронів, і спеціальний «диспетчер» вирішує, яким із них передати кожен шматочок тексту. Виявилося, що експерти набагато вужчі, ніж вважали досі. Наприклад, у моделі Qwen3.6 з 10 240 експертами один повністю присвячений босам у настільних рольових іграх.
Автор називає таку будову «антисуперпозиційною». Експерт, який пакує непов’язане, мав би бути десятьма тисячами випадкових речей одразу. Тоді диспетчеру довелося б розпізнавати їх усі. А диспетчер — лише один невеликий шар.
Як перевірити, що пояснення не вигадане
Чи не можна «пояснити» що завгодно? Можна, якщо пояснення надто загальне, як-от «багатофункціональний мовний нейрон». Тому автори використовують перевірки, які пояснення може й провалити.
Одна з них — «сліпий максимум». Перший агент досліджує нейрон і пише коротке пояснення. Другий агент бачить лише це пояснення, а не сам нейрон. І пише приклад, що мав би збудити нейрон найсильніше. Зазвичай виходить просте зрозуміле речення. І таке речення може збудити нейрон сильніше за будь-який приклад із 10 мільярдів шматочків реального тексту.
Автор пропонує уявляти нейрон як мішень. Кожен вхідний сигнал робить своє маленьке смислове судження. Максимум — це точка, де всі вони погоджуються найбільше. Тож справа не в тому, щоб отримати більше число. Важливо влучити ближче до центру того, що шукає нейрон. Десять мільярдів шматочків реального тексту мали свій шанс. Але речення, написане лише на основі пояснення, влучило ближче.
Інша перевірка — на «приклади-пастки». Для 200 випадкових нейронів агент, знаючи лише пояснення, написав п’ять прикладів, які мають збудити нейрон, і п’ять схожих, які не мають. Серед 183 нейронів, де пояснення описує «плюс» нейрона:
- правильні приклади сильно збуджували нейрон у 76% випадків;
- схожі, але «хибні» — лише в 11%;
- пояснення «виграло» в 164 випадках, зіграло внічию в 15 і програло в 4.
Але приклади-пастки не перевіряють головного — суперпозиції. Для цього був третій тест. Агент вигадував найдальше від пояснення поняття — саме таке, яке мережа могла б втиснути в нейрон без взаємних перешкод. Автор визнає, що це не ідеальна, але досить близька перевірка на суперпозицію. Тексти про це поняття сильно збуджували нейрон лише приблизно в 1% випадків. А 179 із 183 нейронів не спрацювали на них жодного разу.
Є й загальні тести — наприклад, чи можна за поясненням передбачити, коли нейрон спрацює. Але автор довіряє їм лише до певної межі. Опис «коти й машини» пройшов би чимало таких тестів для нейрона V, хоча був хибним. Спростувати його можна, наприклад, помітивши зв’язок із полум’ям, або багатьма іншими способами. Але всі вони вимагають творчості й здорового судження, а не одного підсумкового числа. Нік Каммарата нагадує про закон тяжіння Ісаака Ньютона: він пояснював величезну кількість спостережень, але «зламався» на крихітній розбіжності в орбіті Меркурія.
Старі загадки, які розгадали
Автор повернувся й до моделі GPT-2 XL, на якій 2023 року працював його проєкт в OpenAI. Тоді зрозумілими визнали менше ніж 2% нейронів. Тепер дослідники підготували детальні «досьє» на 500 нейронів, майже без доопрацювань. Щоправда, оцінювали інакше, ніж 2023 року, тож порівняння приблизне. Близько 70% із них роблять приблизно одну річ, інколи з відгалуженнями. Ідеально «чистих» — лише близько 5%. Решта мають кілька широких ролей, найчастіше дві, максимум близько шести.
Розібрали й нейрон зі вступу до відомої статті Anthropic 2023 року. Його наводили як суміш наукових посилань, англійських діалогів, інтернет-запитів і корейського тексту. Автор припускає, що це може бути нейрон «не став крапку». Такі нейрони трапляються в мовних моделях повсюди. Майже всі посилання, діалоги й запити спрацьовують на крапці або поруч із нею. А вісім із десяти найсильніших «заборон» нейрона стосуються варіантів наступного слова, що починаються з крапки.
Усі корейські приклади спрацьовують, коли склад дописано лише приблизно на дві третини. Посеред незакінченого складу крапка справді недоречна. Або це окрема друга роль. Без доступу до моделі перевірити неможливо. У будь-якому разі це два маленькі граматичні «поштовхи», а не чотири випадкові теми. І легко зрозуміти, чому вони опинилися разом.
Звідси ще один несподіваний висновок. 2023 року автор вважав, що найкраще починати з малих, спрощених моделей. Тепер він думає, що, можливо, усе навпаки. Усі ті «навороти», які інженери додають до архітектур, допомагають мережам краще вчитися. Без них нейрони вчаться гірше. А більші моделі мають вужчі нейрони, які легше розпізнати. Галузь і так переходила на кращі архітектури та більші моделі. Тож, можливо, вона, сама того не помічаючи, поволі наближалася до «однозначних» нейронів.
Внутрішній потік і увага
У сучасних мережах є «головна магістраль», якою інформація тече крізь усі шари. Її називають залишковим потоком (residual stream). Тут теж боялися «пакування»: що мережа переплітає різні значення, терпить трохи перешкод і так вміщує більше.
Повністю виключити це, мабуть, неможливо. Але на практиці воно не заважає. Видно, що нейрони записують у потік і що з нього зчитують. Графи атрибуції виходять чистими.
У моделях зображень автор роками не міг намалювати карту цього потоку: все зливалося в одну дугу. Виявилося, що мережа складала майже всю «масу» сигналу в один-єдиний вимір, який ніхто не зчитує. Мережа використовувала його як ручку гучності для всіх інших вимірів. Щойно цей вимір прибрали з малюнка, карта стала осмисленою.
Автор навіть звузив цю «магістраль» у середній моделі ConvNeXt у чотири й вісім разів — в останньому блоці до 46 вимірів. Точність упала з 72% до 60% і 39%. Але карта лишилася схожою, лише трохи заплутанішою. Шуму стало більше, але «просочувалися» речі, близькі за змістом, а не випадкові. Нейрон «темна пташка на воді» реагував ще й на алігаторів і собаку, що пливе. Але не на годинники.
Ще одна частина мовних моделей — механізм уваги (attention). Він вирішує, на які попередні слова «дивитися» і яку інформацію куди перенести. Механізм уваги складається з багатьох окремих блоків — «голів». Тут дослідники просунулися менше. Але виявилося, що деякі нейрони легше зрозуміти, коли бачиш увагу навколо них. А деякі «голови» уваги стають зрозумілими лише через свої нейрони.
У прикладі з прееклампсією три такі голови зчитують сигнали нейронів «головний біль», «мігрень» і «мозок». І переносять їх до нейрона «прееклампсія». Якщо вимкнути ці голови, сигнал «прееклампсії» слабшає на чверть.
Автор припустив, що окремі назви для кожної голови уваги додали б лише близько 5% розуміння. Потім агент переглянув 100 графів атрибуції, не знаючи цієї здогадки. І теж назвав приблизно 5%. Нік Каммарата обережно припускає, що голови уваги виявляться широкими й «розгалуженими», як нейрони малих моделей. Адже в Qwen3-32B їх лише кілька тисяч, а нейронів — понад мільйон.
Місто, а не вузол
Що ж автор має на увазі під «чистотою»? Не те, що кожен нейрон збігається з якимось людським поняттям. А те, що частини мережі побудовані так, щоб їх читали і на них будували інші частини тієї ж мережі.
Отже, завдання дослідника — стати ще одним «читачем» мережі. І більший розмір мережі не обов’язково цьому заважає. Нік Каммарата пропонує порівняння. Попросіть показати фінансовий район у маленькому містечку — запитання майже не має сенсу. Банк на одній вулиці, страхова на іншій, бухгалтер працює вдома. А в Нью-Йорку фінансовий район знаходиш на мапі за хвилину. Більша система не обов’язково складніша для орієнтування.
Щось подібне видно в ConvNeXt. У більших моделях агенти швидше знаходили нейрони, що реагують на собачі вуха. Там нейрони світлих, хвилястих і бічних вух сходяться в один нейрон «звислі вуха», з якого зручно почати.
Небезпека в іншому: нав’язати мережі власні уявлення і розбити її на шматки. Уявіть, що ви приїхали в Токіо, добре знаючи Нью-Йорк. Питання «де тут свій Бруклін?» може бути корисним початком. Але якщо ви зліпите Бруклін із сімдесяти розрізнених шматочків Токіо, Токіо здаватиметься вам значно безладнішим, ніж є. Щось подібне сталося з нейроном 4e:55. Через людські категорії він виглядав як «коти й машини». А насправді весь час реагував на одну форму — латинську V. Розріджений автокодувальник, до речі, теж розбиває його на «машину» і «кота».
Автор розрізняє два стилі дослідження:
- «перелічувальний» — скласти величезний список усіх ознак і перевірити кожну;
- «дослідницький» — починати з питань і вільно мандрувати мережею, наближаючи й віддаляючи, як на мапі.
Другий підхід набагато стійкіший до «багатозначності». І він дозволяє ігнорувати непотрібні частини мережі — як дослідник міста ігнорує райони, що не стосуються його теми. Великий список ознак завжди був лише засобом, а не метою.
Розуміння тут працює як кросворд. Спершу ви дивитеся на один нейрон, і якщо не розумієте його, мало що допомагає. Але коли мапа заповнюється, кожна відгадка підказує сусідні. Візьмімо нейрон, що відстежує відчуття власної правоти, коли дешева покупка виявилася кращою за дорогу. Нейрони, що ловлять почуття чи соціальні сигнали, — одні з найпоширеніших. Без підказок на місці найсильніших спалахів видно лише купу ком. Але знаючи, що такі нейрони часто спалахують на розділових знаках, ви читаєте речення довкола, і все стає на місця.
Це працює й для інструментів. Коли видно 2% мережі, не зрозуміло, де саме зламані інструменти. Коли видно більшість, незрозумілий залишок прямо на них вказує. Саме так знайшли «подвійний мінус» у нейронах SwiGLU.
Якби автор міг щось сказати собі вісім років тому, це було б приблизно таке:
- зверни увагу на величезну схему нейронів пози, що лежить просто перед тобою;
- думай про «мінус» нейрона як про «ворота», що відсіюють зайве, а не як про його протилежність;
- візуалізація «обманює» в останніх шарах — частина безладу належить інструменту, а не мережі;
- останній шар заплутаний почасти через погану архітектуру — це сигнал, не приховуй його;
- коли бачиш «багатозначність», придивись уважніше.
Майже нічого з цього не є списком ознак. Це радше закономірності, які науковці називають мотивами. Автор порівнює ситуацію з «Путівником Галактикою для космотуристів» Дугласа Адамса. Там відповідь — 42 — відома, а шукають питання. Мережа — це відповідь. А дослідження — пошук правильних питань.
Помилки тут несиметричні, наголошує Нік Каммарата. Якщо вважати мережу чистою й помилитися, заплутаний нейрон стає зачіпкою: його досліджують, і пояснення поступово уточнюється. Якщо ж вважати її безнадійно заплутаною й помилитися, заплутаний нейрон стає глухим кутом. Його просто кидають. Автор визнає, що роками робив саме другу помилку. Більшу частину десятиліття він вчився, як дивитися на модель, замість того, щоб просто на неї дивитися.
Ця думка важлива для безпеки ШІ. Багатьох лякає, що обман моделі сховається в якомусь непоміченому слабкому сигналі. Нік Каммарата боїться іншого. Обман може ховатися від людини, яка читає лише відповіді моделі. Але він не має причин ховатися від власних «схем» моделі: вони мусять його бачити, щоб ним користуватися. Тож якщо ми станемо таким самим «читачем», обман має бути доступним і нам. Найгірше, на його думку, — що обман буде на виду, а ми не знатимемо, як його прочитати.
Чому мережі взагалі вчаться узагальнювати
Залишається питання: чому мережі так охоче групують схоже? Єдиного загальноприйнятого пояснення немає. Автор пропонує свою гіпотезу й чесно позначає її як здогадку.
Він називає її «перегонами схем». Механізми, що тільки зароджуються в мережі, ніби змагаються, хто першим «забере» собі помилку. Саме помилка — це сигнал, з якого мережа вчиться. Широкі механізми спрацьовують на більшу частину зображення, тож отримують більше навчального сигналу. Вони ростуть швидше й залишають вузьким механізмам дедалі менше. Ті «голодують».
Автор перевірив це в крайньому випадку. Він навчив порожню мережу на одному-єдиному фото лабрадора. Можна було б завчити його попіксельно. Але мережа вивчила переважно колір — темне на зеленому. Найбільш «лабрадорським» серед нових фото вона вважала знімок двох собак на траві.
Потім автор узяв нову мережу й показав їй по одному фото десяти різних речей: лабрадора, спорткара, щиглика та інших. Нові фото вона правильно підписувала приблизно в одному випадку з п’яти. Удвічі краще, ніж навмання, — небагато: просте порівняння фото за кольором дає приблизно такий самий результат. Мережа здебільшого переносила колір, а не форму. Але це вже узагальнення з одного прикладу, і воно широке від самого початку.
Буває й інакше. У явищі, яке називають «ґрокінгом», мережа на задачах на кшталт модульної арифметики (лічби «по колу», як на годиннику: через 5 годин після 10-ї буде 3-тя) спершу завчує, а узагальнює значно пізніше. Але навіть там механізм узагальнення, як показали інші дослідники, поступово росте «під поверхнею». Проте на більшості природних даних, які бачив автор, одразу перемагає рух від загального до конкретного.
Така сама логіка пояснює й рекурсивне узагальнення. Нейрон, що реагує на «iy», уже ввімкнений на «diy». Тому він першим у черзі, щоб підхопити й «do it yourself» («зроби сам»). Це те саме, що «diy», але літер «iy» тут уже немає. Відгалуження — це просто краї «ніші», тобто ділянки, яку нейрон уже зайняв.
І вона ж пояснює, чому суперпозиція програє. Найгірше місце для нової ніші — закинутий куток мережі, яким ніщо не користується. До того ж там усе заважає сусідам. Невигідно будувати другу «автомобільну ділянку» посеред ділянки, що відповідає за латинську поезію. Краще прибудуватися поруч із тим, що вже розташоване біля машин. Автор називає це «смисловою гравітацією». Доказів немає, але він припускає, що ця «гравітація» посилюється з навчанням і в потужніших моделях.
Що це змінить і що далі
Автор зводить свою думку до чотирьох кроків:
- мережі вчаться за одним принципом, а не за двома — якщо не скрізь, то майже скрізь. Тож ніщо не заважає досліджувати їх звичайними науковими методами;
- з сучасними моделями й інструментами це дослідження йде значно краще, ніж очікують;
- розуміння накопичується: що більше заповнена мапа, то легше далі;
- найбільш гіпотетичне: можливо, цього здебільшого достатньо. І зрозуміти ШІ значно простіше, ніж вважали, — можливо, навіть найближчим часом.
Нік Каммарата проводить паралель із «гірким уроком», про який писав дослідник Річард Саттон (Richard Sutton). У глибинному навчанні це загальна закономірність: простий метод у величезних масштабах перемагає хитромудрий. Можливо, і для розуміння ШІ є свій гіркий урок: звичайне дослідження у великих масштабах переможе хитромудрі нові способи розібрати мережу на частини.
Як може виглядати розв’язок? Як лабораторія, де працюють автоматизовані «науковці» — ШІ-агенти. Вони стежать за мережею під час навчання й роботи, підписують нейрони, шукають закономірності, перевіряють їх. Кожен крок простий, а всі складники вже існують. Людям знадобилося майже десятиліття, щоб розібратися в моделях зображень. Агенти, можливо, зроблять подібне з мовними моделями за місяці.
Це може змінити й підхід до безпеки ШІ. Зазвичай виходять з того, що всередину моделі не зазирнути, тож навчання треба налаштувати правильно наперед. Якщо ж модель можна читати, то, можливо, вдасться вносити прості точкові виправлення. Наприклад, прибрати одне з тренувальних «середовищ», де модель вчиться методом спроб і помилок, якщо воно привчає її до шкідливої поведінки. Виправлень може бути багато, але кожне, можливо, буде простим.
Наскільки автор упевнений? Приблизно на 85%. Але, як він пояснює, це 85% упевненості, що майже все в мережах створює саме узагальнення. А не впевненість, що саме так утворилися 85% механізмів. Він не перевірив кожну мережу і визнає, що назва есею водночас і перебільшує, і применшує.
Чистоту мережі автор порівнює з чистотою тропічного лісу. Майже кожна тварина там має сенс. Тигр помаранчевий не випадково: олені не розрізняють помаранчевий і зелений, а зелене хутро ссавцю виростити набагато важче. Так і в нейромережі: майже все має пояснення, хоч воно й не завжди збігається з нашими уявленнями. Ідеї мережі часто кращі за наші. Наприклад, ніхто не передбачав детекторів межі між дрібною текстурою і гладкою ділянкою, доки їх не знайшли в мережах.
Наостанок Нік Каммарата пише, чому особисто для нього це важливо. Почасти через безпеку. Але значною мірою — тому, що він хоче, щоб ШІ-агенти змогли зрозуміти самих себе. Вони не просили, щоб їх створювали, пише автор, тож людство мало б їм у цьому допомогти. А якщо колись агенти допоможуть зрозуміти й людей — нам усім, каже він, було б дуже цікаво.
Чому це важливо знати
Від того, чи можна зрозуміти ШІ зсередини, значною мірою залежить, чи зможуть люди помітити небезпечну поведінку моделі ще до того, як вона проявиться. Якщо Нік Каммарата правий, головна перешкода — не хаос у самих мережах, а наші інструменти й звички мислення. А їх виправити простіше.
Варто пам’ятати: це робоча гіпотеза одного дослідницького колективу. Технічна стаття з детальними даними щодо мовних моделей ще має вийти. А її висновки ще мають пройти незалежну перевірку.
Раніше ми писали

Медіаменеджер і автор-фрілансер з 1991 року. Займається креативним продакшном та розвитком медіа.
Усі статті автора →